
17:50 / 17 ноября 2026



Международный коллектив ученых представил PackEat – самый большой в мире открытый набор данных для обучения систем компьютерного зрения в ритейле. Над его созданием совместно работали инженер «Яндекса», исследователи Центра искусственного интеллекта «Сколтеха» и Санкт-Петербургского государственного университета аэрокосмического приборостроения (ГУАП). Датасет представляет собой обширную библиотеку фотографий фруктов и овощей и предназначен для повышения точности алгоритмов, используемых в умных кассах и системах автоматического учета товаров. Об этом IT Speaker рассказали в пресс-службе Yandex Cloud.
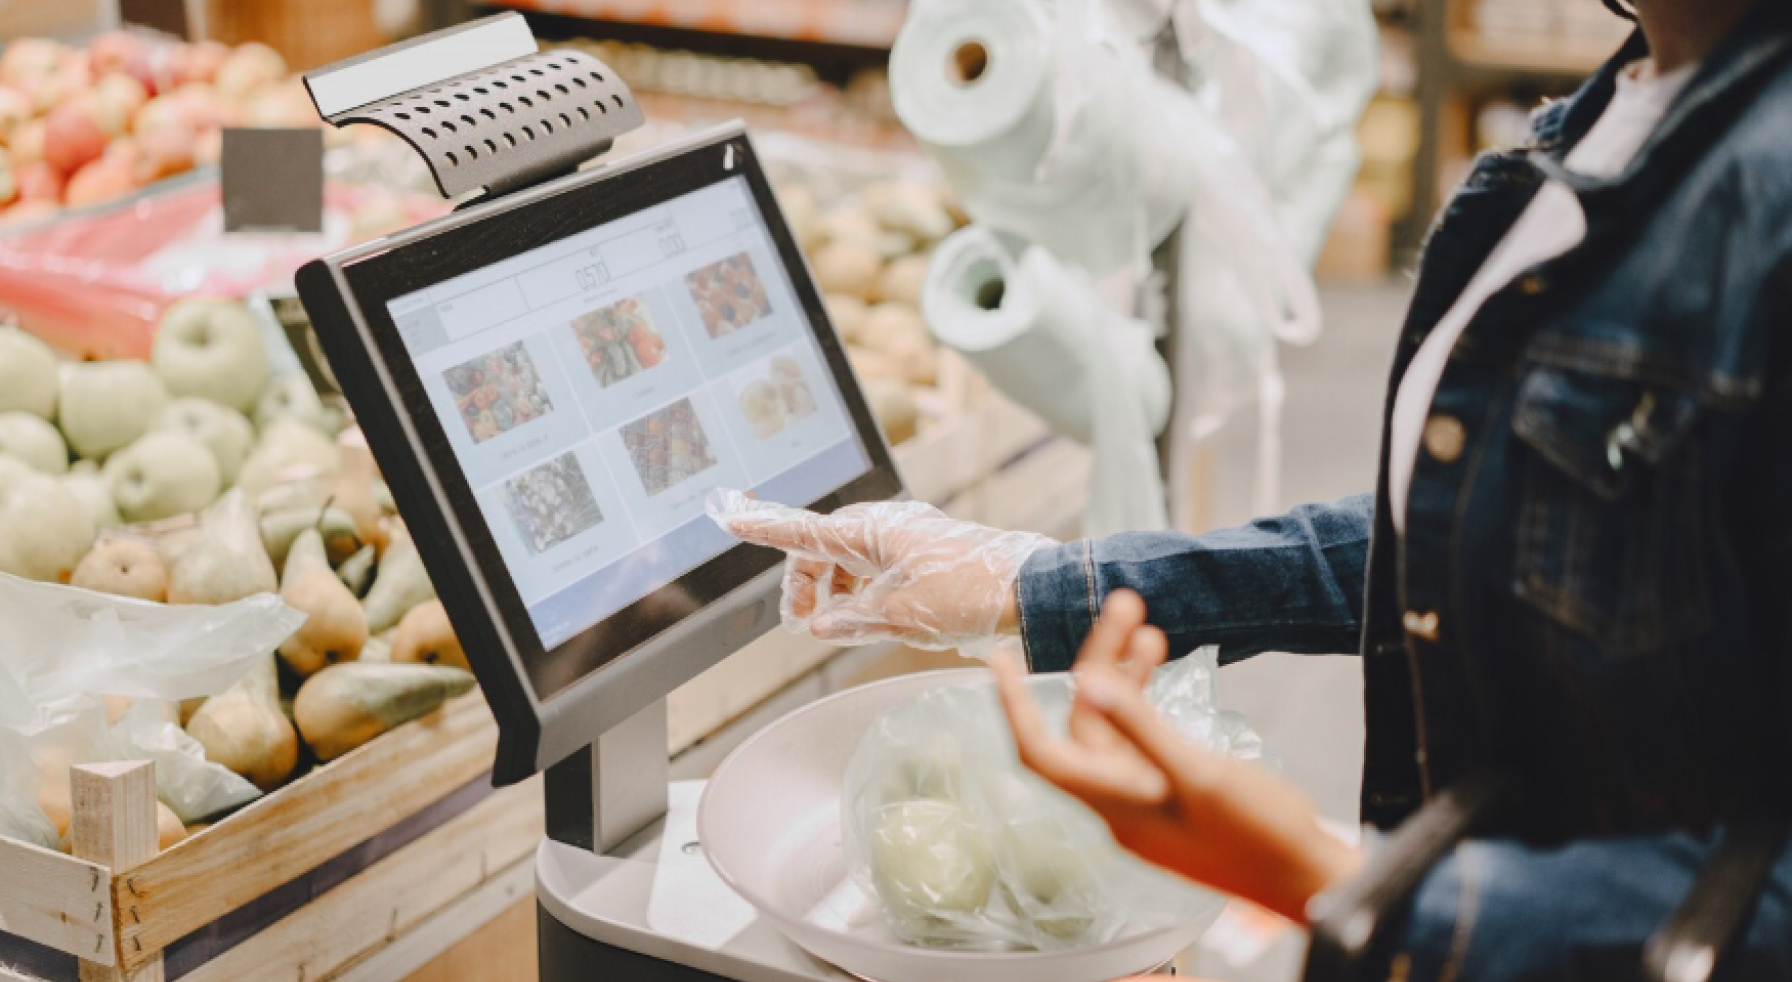
Особую ценность PackEat придает то, что данные собраны в условиях реальных торговых залов. На снимках продукты запечатлены в полиэтиленовых пакетах, частично перекрывают друг друга и расположены на «шумном» фоне стандартных прилавков. Это позволяет обучать нейросети решать практические задачи, с которыми они сталкиваются в супермаркетах, – корректно распознавать товары, несмотря на сложные условия съемки.
В общей сложности датасет содержит свыше 100 тысяч изображений, на которых запечатлено более 370 тысяч отдельных объектов. Он охватывает 34 вида и 65 сортов популярных фруктов и овощей, снятых под разными углами в магазинах нескольких городов. Около 9 тысяч снимков имеют детальную разметку с указанием границ каждого объекта, его количества и общего веса в упаковке. Такой объем и качество данных делают PackEat уникальным инструментом для решения ключевых задач: точного распознавания видов и сортов, сегментации пересекающихся продуктов и автоматического подсчета единиц товара.
Публикация этого ресурса призвана помочь ритейлу в решении давней проблемы – ручной идентификации весовых товаров, которая часто приводит к ошибкам и финансовым потерям. Исследования показывают, что правильно обученные нейросети способны достигать точности распознавания до 92%, что открывает путь для массовой автоматизации процессов. Полное описание датасета опубликовано в научном журнале Scientific Data. Сам набор изображений доступен на платформе Zenodo, а примеры кода и моделей – на Kaggle, что позволяет мировому сообществу разработчиков и исследователей сразу применять их в своих проектах.
Ключевую роль в исследовании сыграли Сергей Нестерук из Yandex Cloud, чья научная деятельность связана с компьютерным зрением, и Светлана Илларионова, руководитель группы «Компьютерное зрение для обработки данных» Центра ИИ «Сколтеха». В настоящее время Сергей Нестерук возглавляет команду безопасности искусственного интеллекта в Yandex Cloud, а Светлана Илларионова реализует исследовательские проекты по применению алгоритмов компьютерного зрения в различных областях, от спутникового мониторинга до медицинской диагностики, и автор более 25 научных работ.
Ранее исследователи AI VK выложили в открытый доступ датасет VK-LSVD (Large Short-Video Dataset). Используя его, разработчики могут улучшать рекомендательные алгоритмы, чтобы делать сервисы и продукты более персонализированными.
Поделиться новостью
17:50 / 17 ноября 2026
17:10 / 17 ноября 2026
16:30 / 17 ноября 2026
15:50 / 17 ноября 2026
 «Сбер» представил портативную умную колонку
16:30 / 17 ноября 2026
 Cloud.ru займется национальной сертификацией ИТ-специалистов в облаках
15:50 / 17 ноября 2026

Соцсети и мессенджеры
Цифровизация
15:10 / 17 ноября 2026
 VK Tech запустил подключение ИИ-агентов в проектах VK WorkSpace
13:50 / 17 ноября 2026